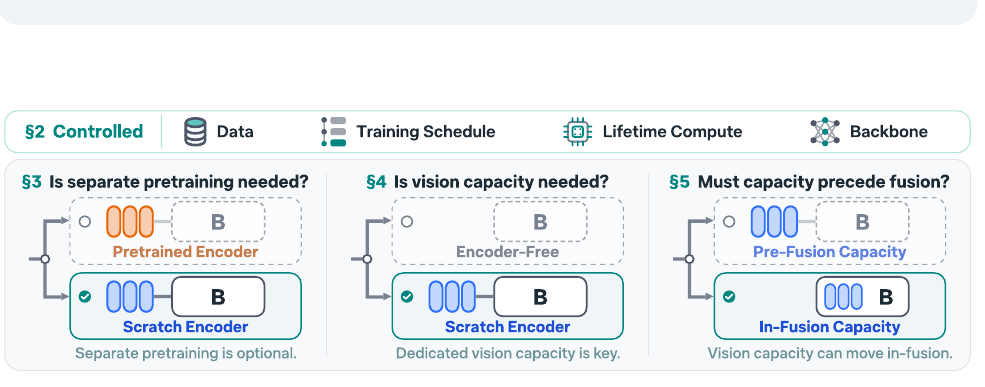
Unbundling Multimodal Vision Encoding
Weekly Paper Notes — one of the top picks from the 2026-11-14 CS paper digest. Area: AI / ML. Authors: Ellis Brown, Chris Hoang (equal contribution), Shengyi Qian, Shang-Wen Li, Mike Lewis, Marjan Ghazvininejad, Luke Zettlemoyer, Lucas Beyer, Mengye Ren, Jakob Verbeek, Saining Xie, Hu Xu (Meta FAIR, New York University) arXiv: 2611.17334 · PDF · Project page TL;DR Most vision-language models bolt a separately pretrained image encoder (CLIP, SigLIP and relatives) onto a language model....